天玑9600Pro亮相半导体博览会,全大核+双NPU重构旗舰体验
2026-11-18 18:00:09
2611
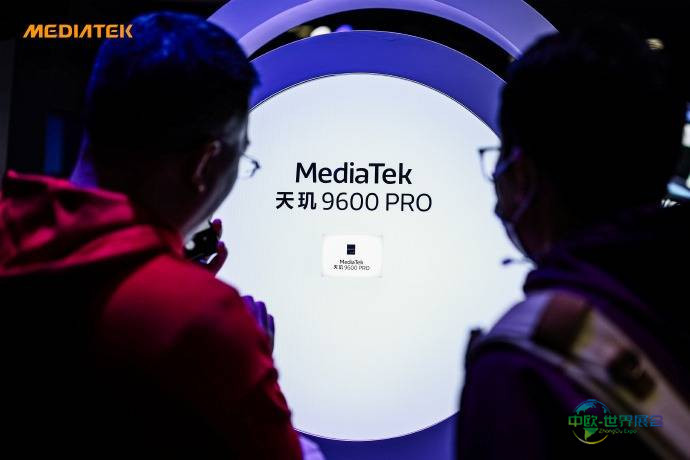
11月12日至14日,第二十三届中国国际半导体博览会(IC China 2026)在北京举行。联发科携旗下全场景AI芯片方案参展,其中天玑9600 Pro旗舰芯片作为移动计算领域的核心展品重磅亮相。
该芯片基于台积电2nm制程工艺打造,采用2+3+3全大核CPU与双NPU深度协同的AI原生架构,搭配天玑AI智能体化引擎3.0,在端侧大模型响应速度、AI影像创作等多个维度实现全面升级,目前已量产应用于vivo、OPPO等品牌的旗舰机型。
2nm制程与全大核架构 筑牢旗舰性能与能效底座
作为业界首批采用台积电2nm制程的旗舰芯片,天玑9600 Pro依托先进工艺与DTCO设计工艺协同优化,在性能与能效两方面实现双重突破。其CPU部分采用全新的2+3+3全大核架构,包含2颗最高主频4.55GHz的C2-Ultra超大核、3颗主频4.35GHz的C2-Pro大核与3颗主频3.1GHz的C2-Pro大核,搭配34.5MB缓存架构,并率先支持LPDDR6内存与UFS 5.0闪存。
官方数据显示,天玑9600 Pro的单核性能较上一代提升17%,多核性能提升15%,多核峰值功耗相比上代降低61%,为端侧AI计算、高负载游戏与专业影像创作提供了充足的算力支撑。
双NPU分工协作,提升端侧大模型运行效率
AI能力是天玑9600 Pro的核心升级方向,也是本次展会的展示重点。该芯片采用超性能NPU 1090+第二代超能效NPU的双NPU架构,配合天玑AI智能体化引擎3.0,针对智能体时代的端侧AI需求进行了全链路优化。
其中,相较上一代超性能NPU 1090的INT4算力实现翻倍,大语言模型预填充性能提升51%,每瓦特生成词元数提升55%,可支持最高30B参数的混合专家(MoE)模型端侧运行。预填充性能的提升直接决定了大语言模型的首词响应速度,用户发出指令后AI助手的反馈延迟大幅缩短,交互更接近自然对话的流畅感。而第二代超能效NPU融合低功耗传感器中枢,NPU功耗相较上一代节省40%,可实现低功耗常驻的场景识别、主动建议等智能体服务,兼顾AI能力与续航表现。
天玑智算融合架构将CPU与NPU深度协同,配合天玑调度引擎,软硬件协同调动算力、电源与内存资源。处理AI影像、AI渲染等复杂任务时,算力资源可灵活调配,既保证了处理效率,也避免了单一模块负载过高带来的发热问题。
AI影像能力落地 赋能旗舰长焦与全焦段创作
除了智能体交互,天玑9600 Pro还将端侧AI能力深度延伸到影像创作场景,这也是终端用户感知最直观的升级方向。其采用的天玑智能影像架构,可直接调用NPU算力完成实时AI降噪、AI超分辨率、AI语义分割与场景优化,让长焦拍摄、暗光拍摄的画质实现质的飞跃。
端侧AI进入体验比拼阶段 算力协同成核心竞争力
随着大模型与智能体逐步成为旗舰手机的标配,端侧AI的竞争早已从“有没有”转向“好不好用”。单纯堆砌NPU算力参数,无法直接转化为流畅的交互体验,CPU、NPU、ISP的深度协同,以及算法与硬件的联合调优,才是决定实际体验的关键。
天玑9600 Pro的核心看点正在于此:它不只是制程与算力的常规升级,更是通过AI原生架构设计,让全大核CPU与双NPU形成高效协同,在提升大模型运行效率的同时,也将AI能力延伸到影像、游戏等用户高频使用的场景中,让端侧AI不再是概念性功能,而是能切实提升使用体验的基础能力。
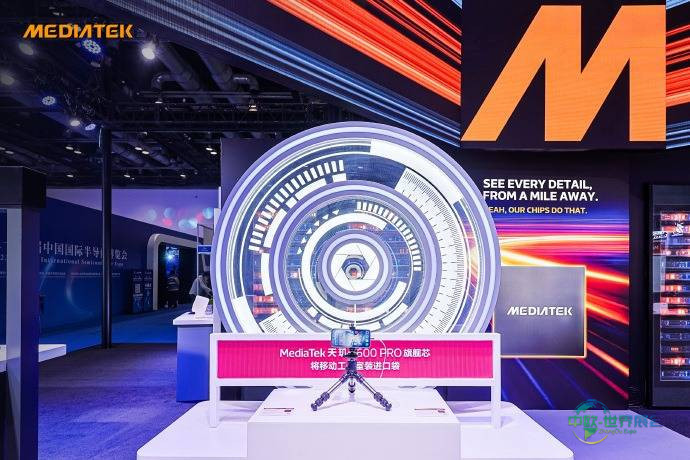
随着vivo、OPPO两大品牌旗舰机型的量产落地,天玑9600 Pro的技术方案已经完成从实验室到消费市场的验证,也为2027年旗舰手机的端侧AI体验树立了新的参考标准。
编辑点评:端侧AI发展到今天,用户需要的从来不是纸面算力数字,而是更快的响应、更省电的常驻服务、更实用的场景落地。天玑9600 Pro用双NPU分工+全大核协同的思路,把AI性能拆成了“高性能计算”和“低功耗感知”两条线,既解决了大模型响应慢的痛点,也兼顾了日常续航,是一次非常务实的技术落地。
本平台所刊载的资讯来源于外部公开信息及合作方提供,由“中欧世界展会网”进行整理编辑,旨在为用户提供便捷的展会信息参考。我们致力于打造一个汇集全球展会时间与地点信息的服务平台,并可提供展位预订、参观协助、设计搭建等第三方服务对接。
相关资讯仅供参考,不构成任何确定性承诺或要约,亦不对其准确性、完整性承担法律责任。用户基于本平台信息所做的任何决策与行为,均需自行核实并承担相应风险。
如需进一步服务或确认信息,敬请垂询:400-837-8606(24小时客服)。